

简介
该库提供了一组 PostgreSQL 扩展,可在 Postgres 中执行 chDB 查询,并在多种数据格式与对象存储之间复制数据。chdb 扩展
chdb 扩展用于运行 chDB 查询。chdb_query() 函数执行单条查询。例如,以下查询:
chdb_hook 模块
chdb_hook 模块挂接到 COPY 命令,可将数据复制到 S3、GCS、Azure Blob、文件或 http URL,也可从这些位置复制数据。以下示例通过单条 COPY 命令从 S3 上的多个 CSV 文件中加载记录:
times 表中就包含了从每个已加载文件中读取的记录:
格式基准测试
有一项benchmark以约 100 万行 NYC Taxi dataset 数据为基础,在多种格式下将 [chdb_hook] 的COPY 性能与 [aws_s3]、[pg_duckdb] 和 [pg_lake] 进行了对比。
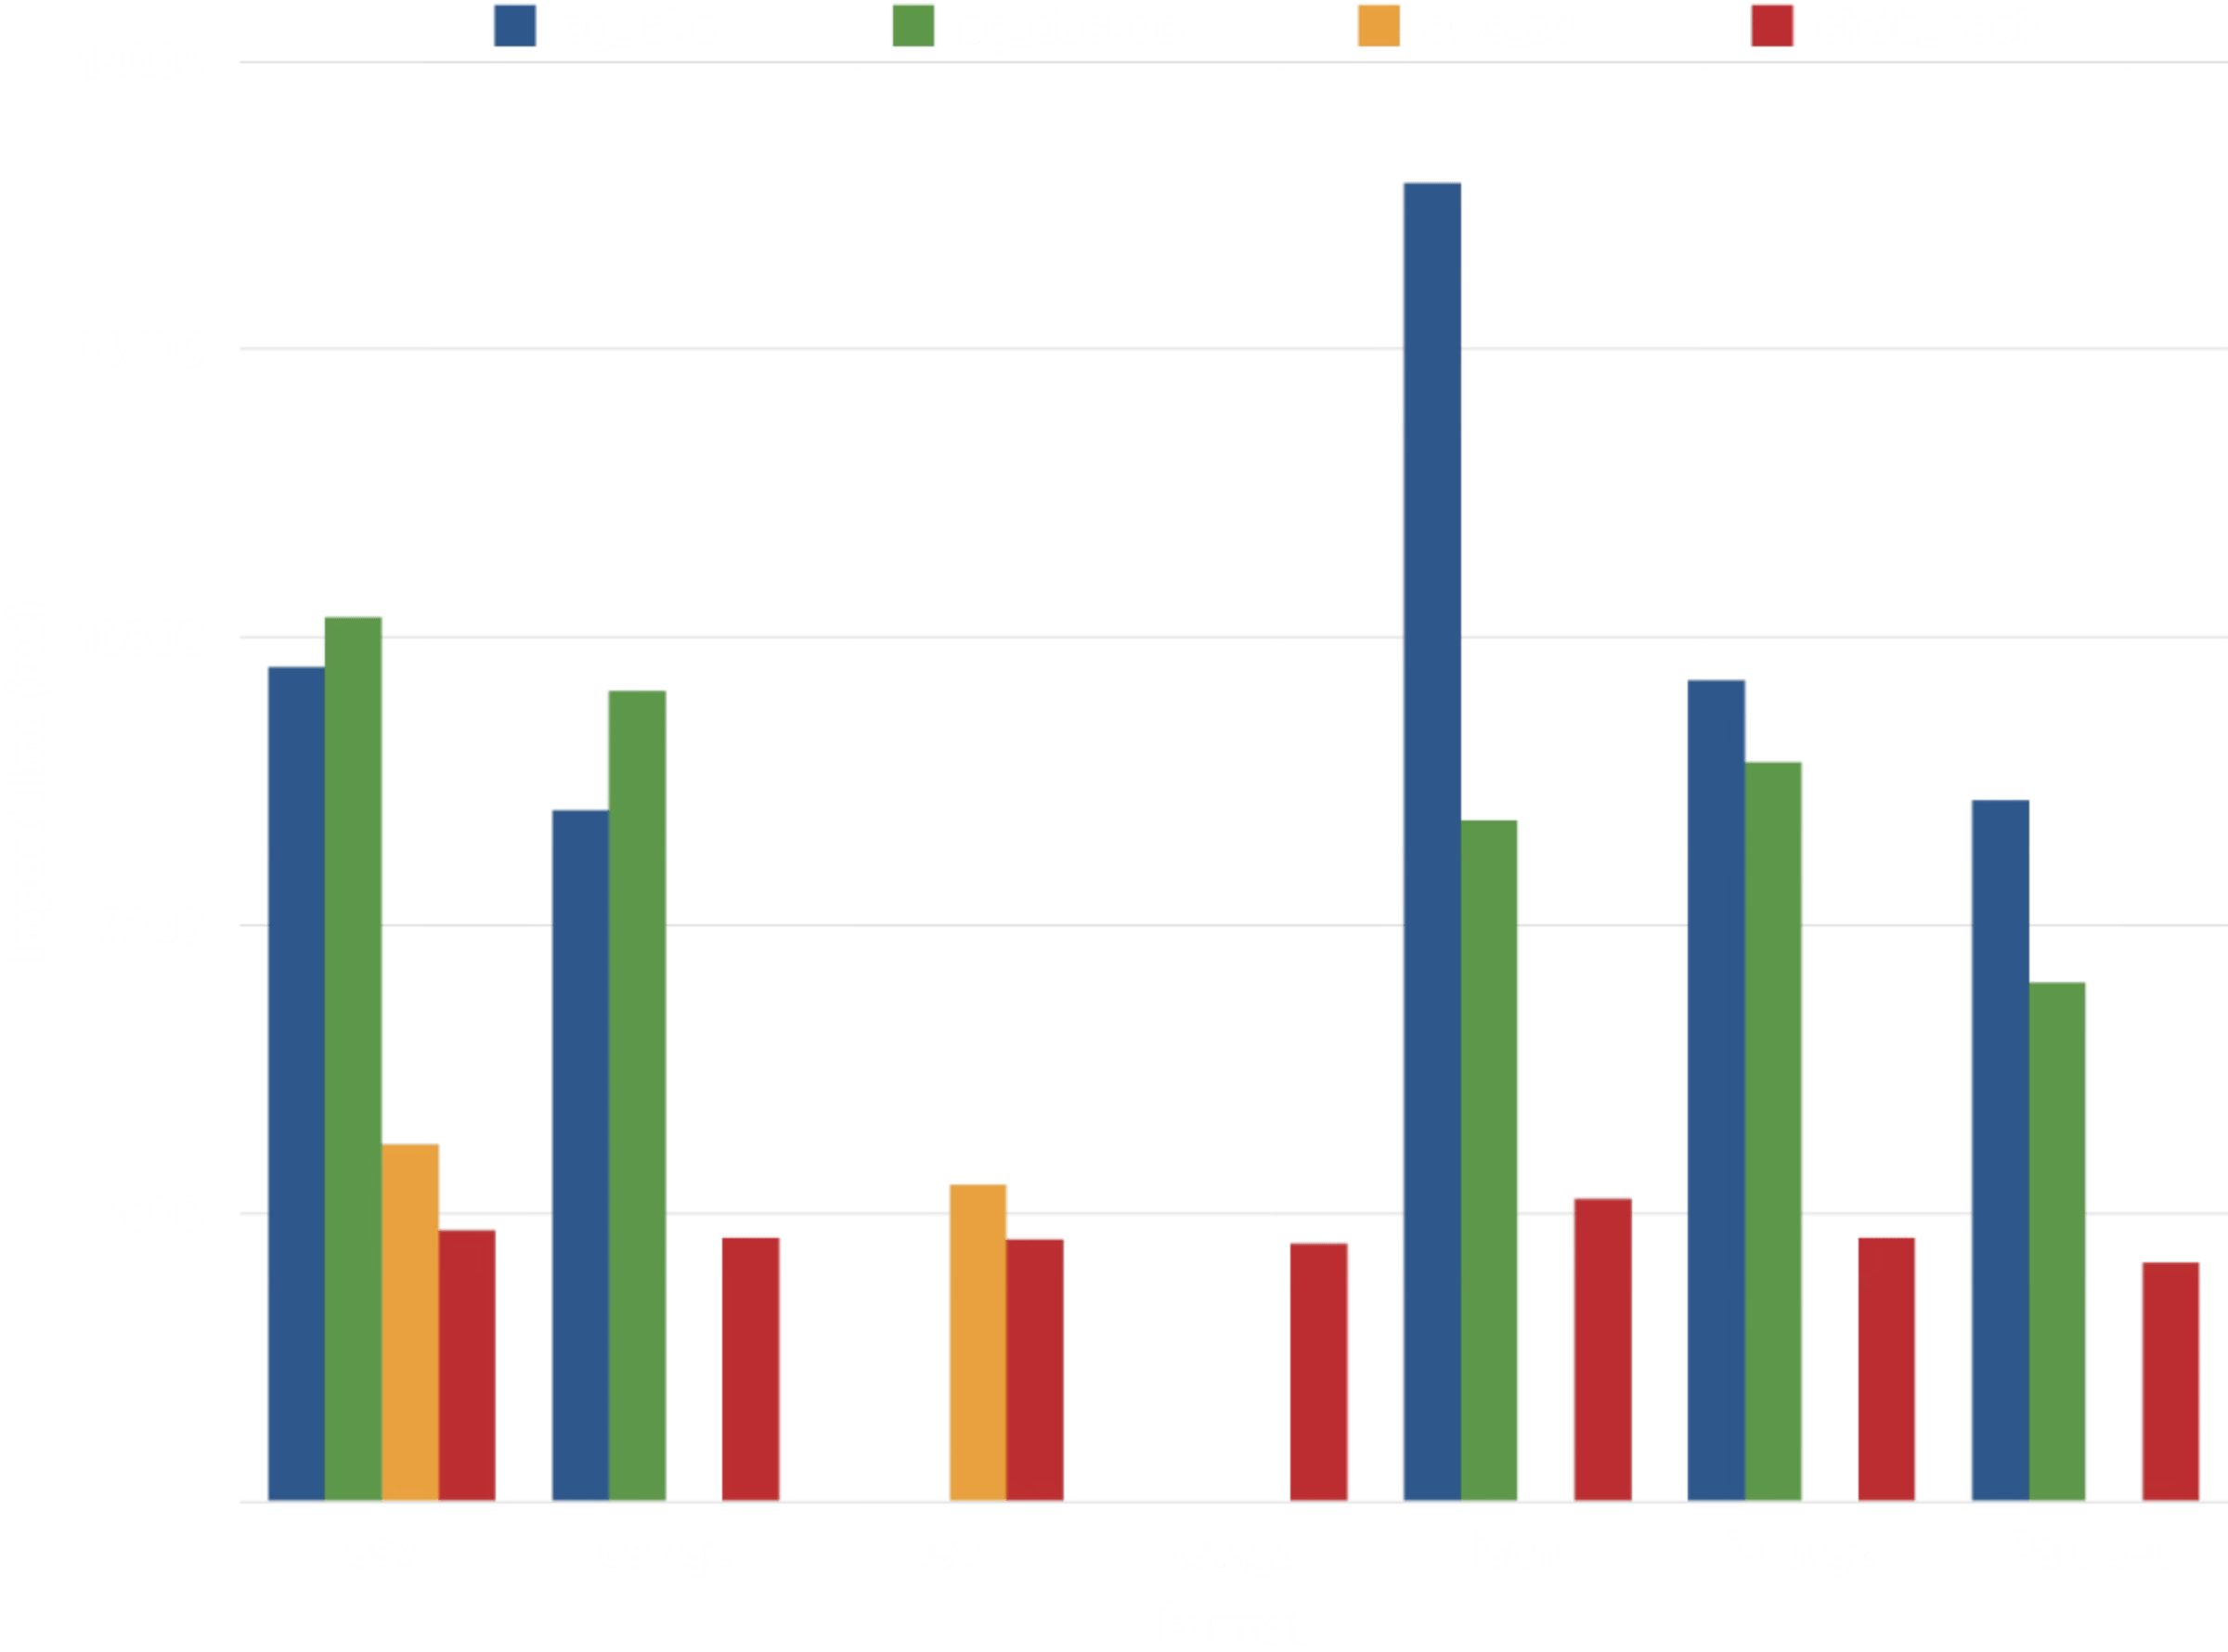
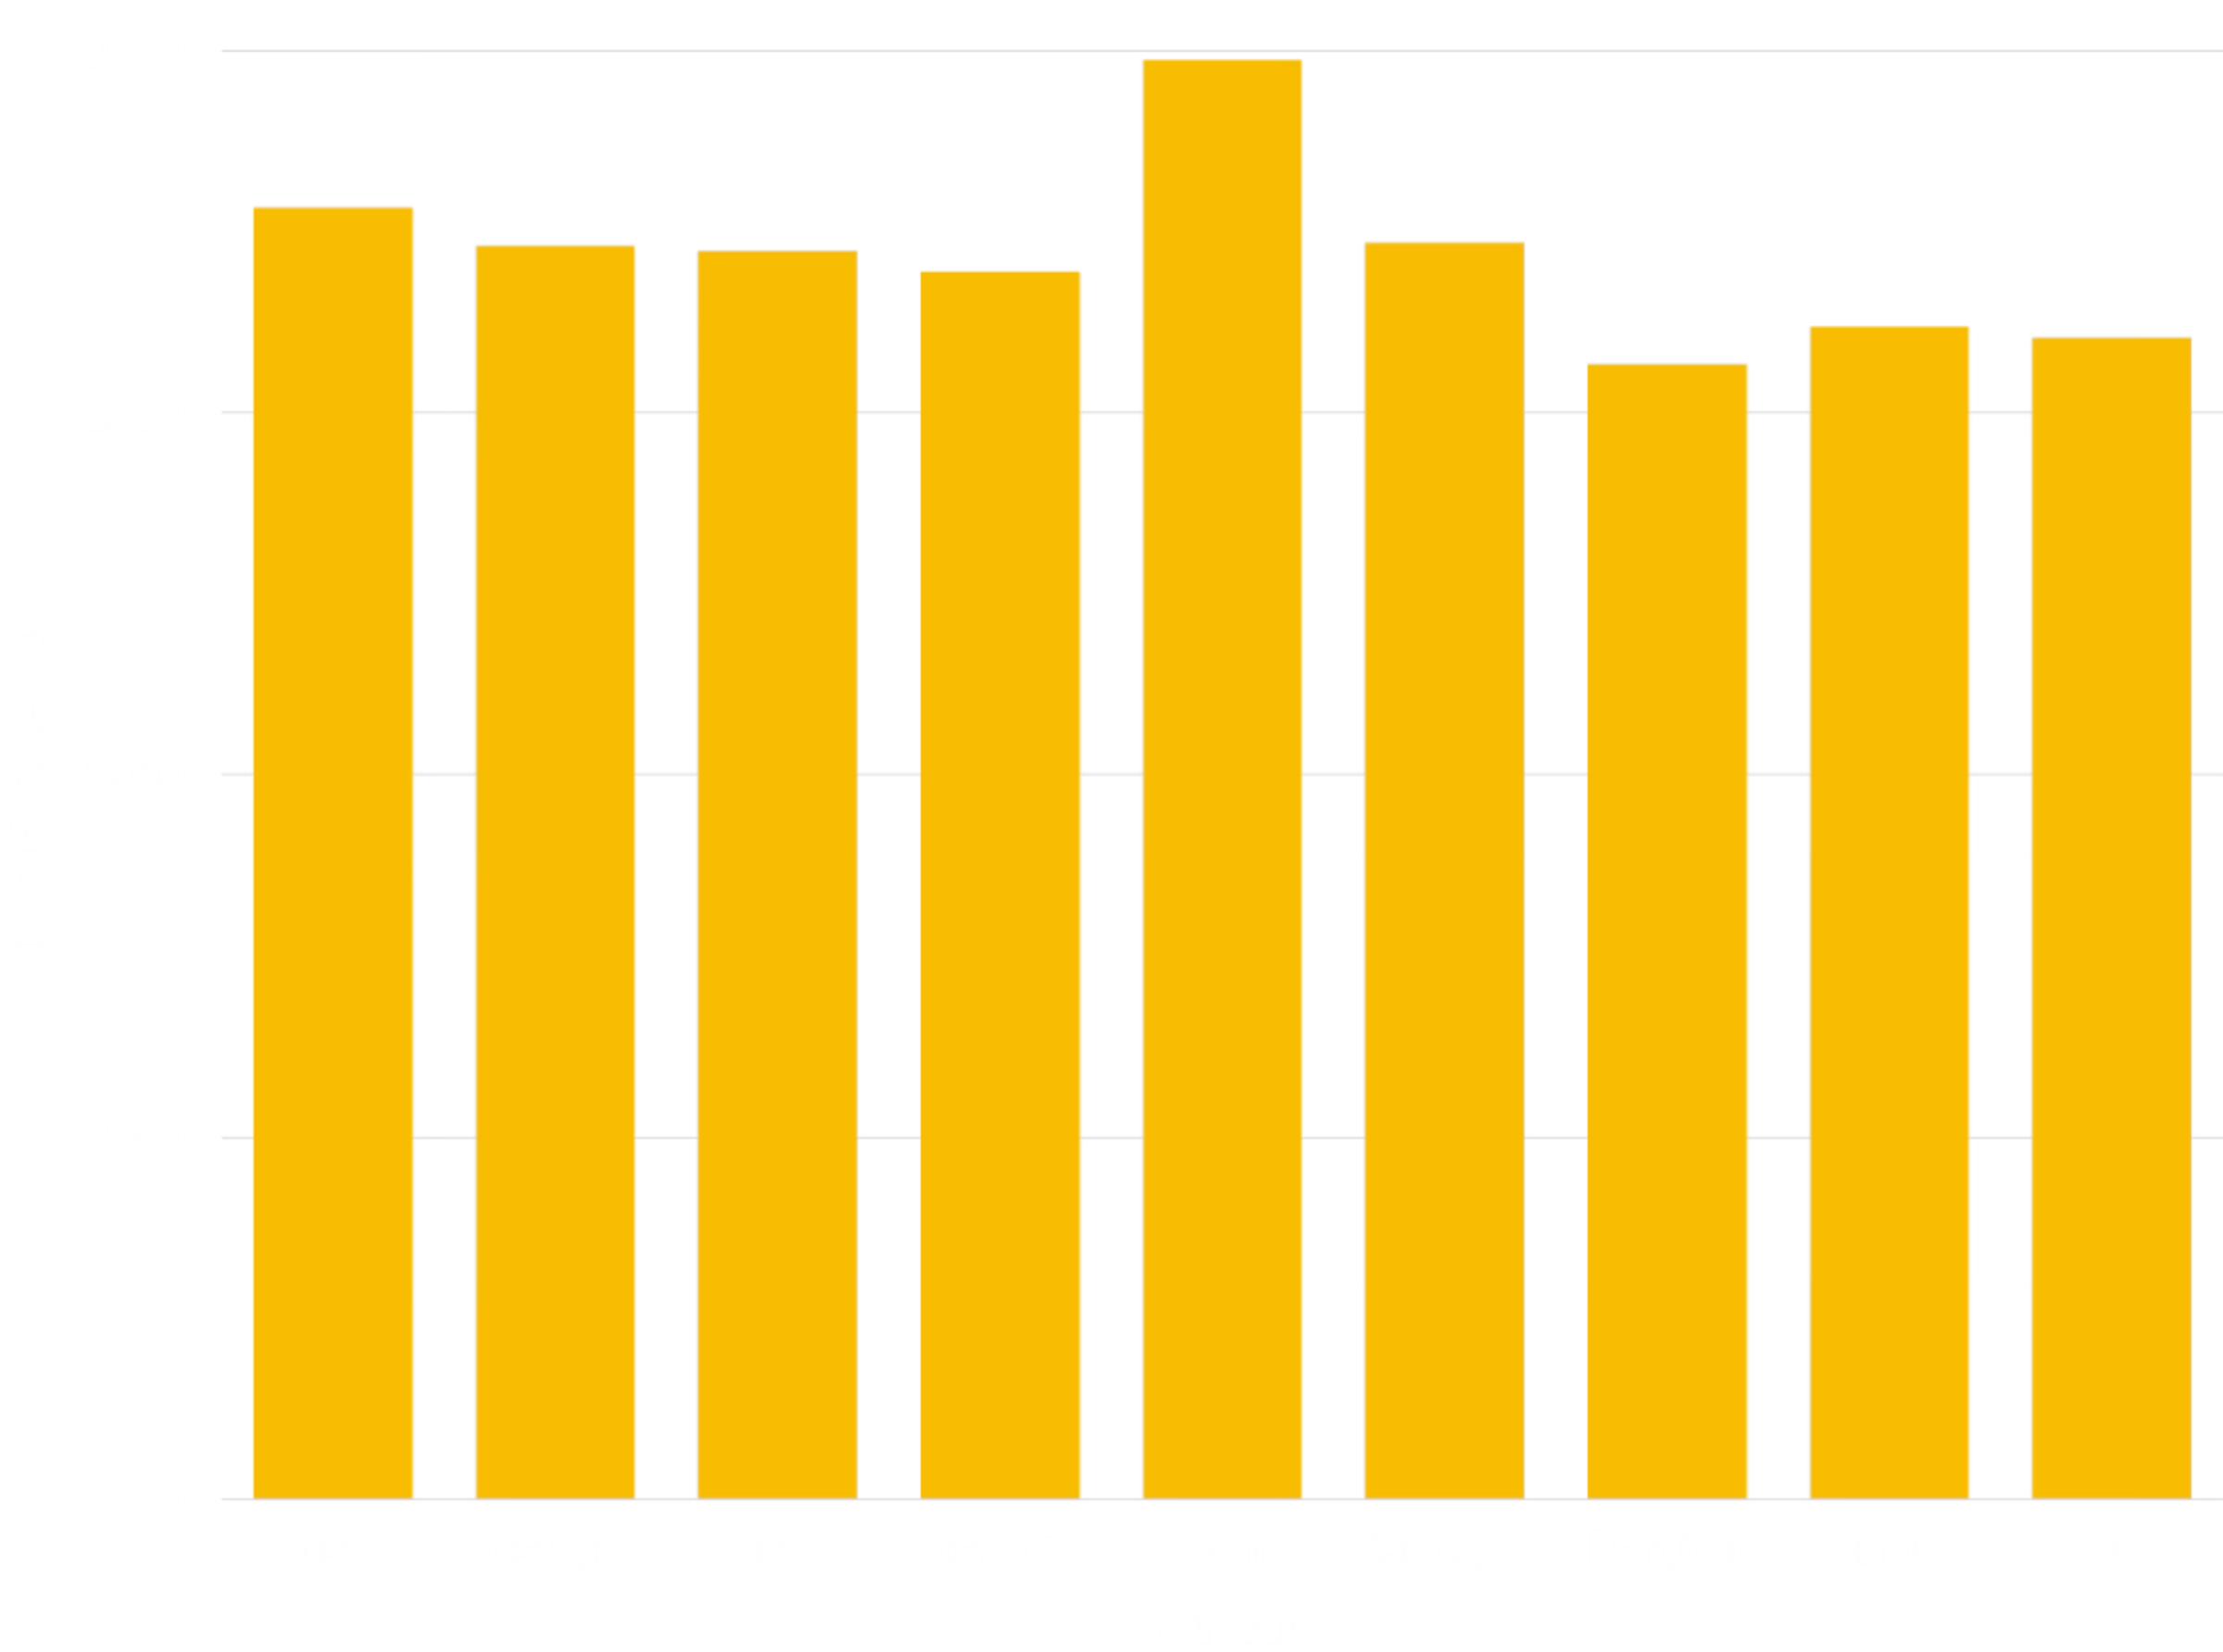
进一步的基准测试表明,以多种格式导入 NYC Taxi dataset 时,性能相对稳定:
架构
chdb 和 chdb_hook 扩展依赖chdb_helper 进程来执行 chDB 查询。该辅助进程将 chDB 的资源占用与 Postgres 主进程隔离开来,对于从数据湖加载数据这类偶尔才会用到的工作流而言,这是一大优势。
依赖项
chdb 扩展 需要 PostgreSQL 15 或更高版本,以及 v26.7.0 或更高版本的 chDB library (目前仅支持 Linux 和 macOS) 。最简单的安装方式是使用 lib.chdb.io shell 脚本:
make 命令之前设置以下变量。
Makefile 会下载静态 libchdb 库,并将其编译进应用中。
在 Linux 上,也可以在执行安装所需的 make 命令前设置 export BUNDLE_LIBCHDB=1,让安装过程改为下载并安装动态 libchdb 库。
从源码编译
要构建 chdb,只需执行以下操作:gmake 的名称安装:
pg_config 并将其加入 path。如果你使用 RPM 之类的包管理系统安装 PostgreSQL,请确保同时安装了 -devel 包。必要时,可以为 build 过程指定它的所在位置:
/usr/local:
install 传递 prefix argument (但不要传给其他 make 目标) :
postgresql.conf
参数] 中包含该前缀: