Экспорт из Langfuse Cloud
Чтобы настроить в Langfuse Cloud интеграцию с Blob Storage для экспорта по расписанию, следуйте этому руководству. Экспорт данных трассировки в объектное хранилище можно запускать не чаще чем раз в20 minutes либо по расписанию hourly, daily или weekly. По умолчанию каждый экспорт включает observations (дополненные атрибутами трассировок) и scores.
Структура экспортируемых файлов
Интеграция Blob Storage в Langfuse Cloud записывает данные в целевой бакет или контейнер хранилища со следующей структурой каталогов:Импорт в ClickHouse Cloud
После настройки интеграции Blob Storage в Langfuse Cloud данные трассировки будут по расписанию экспортироваться в целевой бакет или контейнер хранилища. Чтобы импортировать эти данные в ClickHouse Cloud, воспользуйтесь ClickPipes и его управляемыми коннекторами к объектным хранилищам:| Источник данных | Подробности |
|---|---|
 Amazon S3 и S3-совместимые объектные хранилища | Интеграция через S3 ClickPipes. |
 Google Cloud Storage | Интеграция через GCS ClickPipes. |
 Azure Blob Storage | Интеграция через ABS ClickPipes. |
Создание ClickPipe
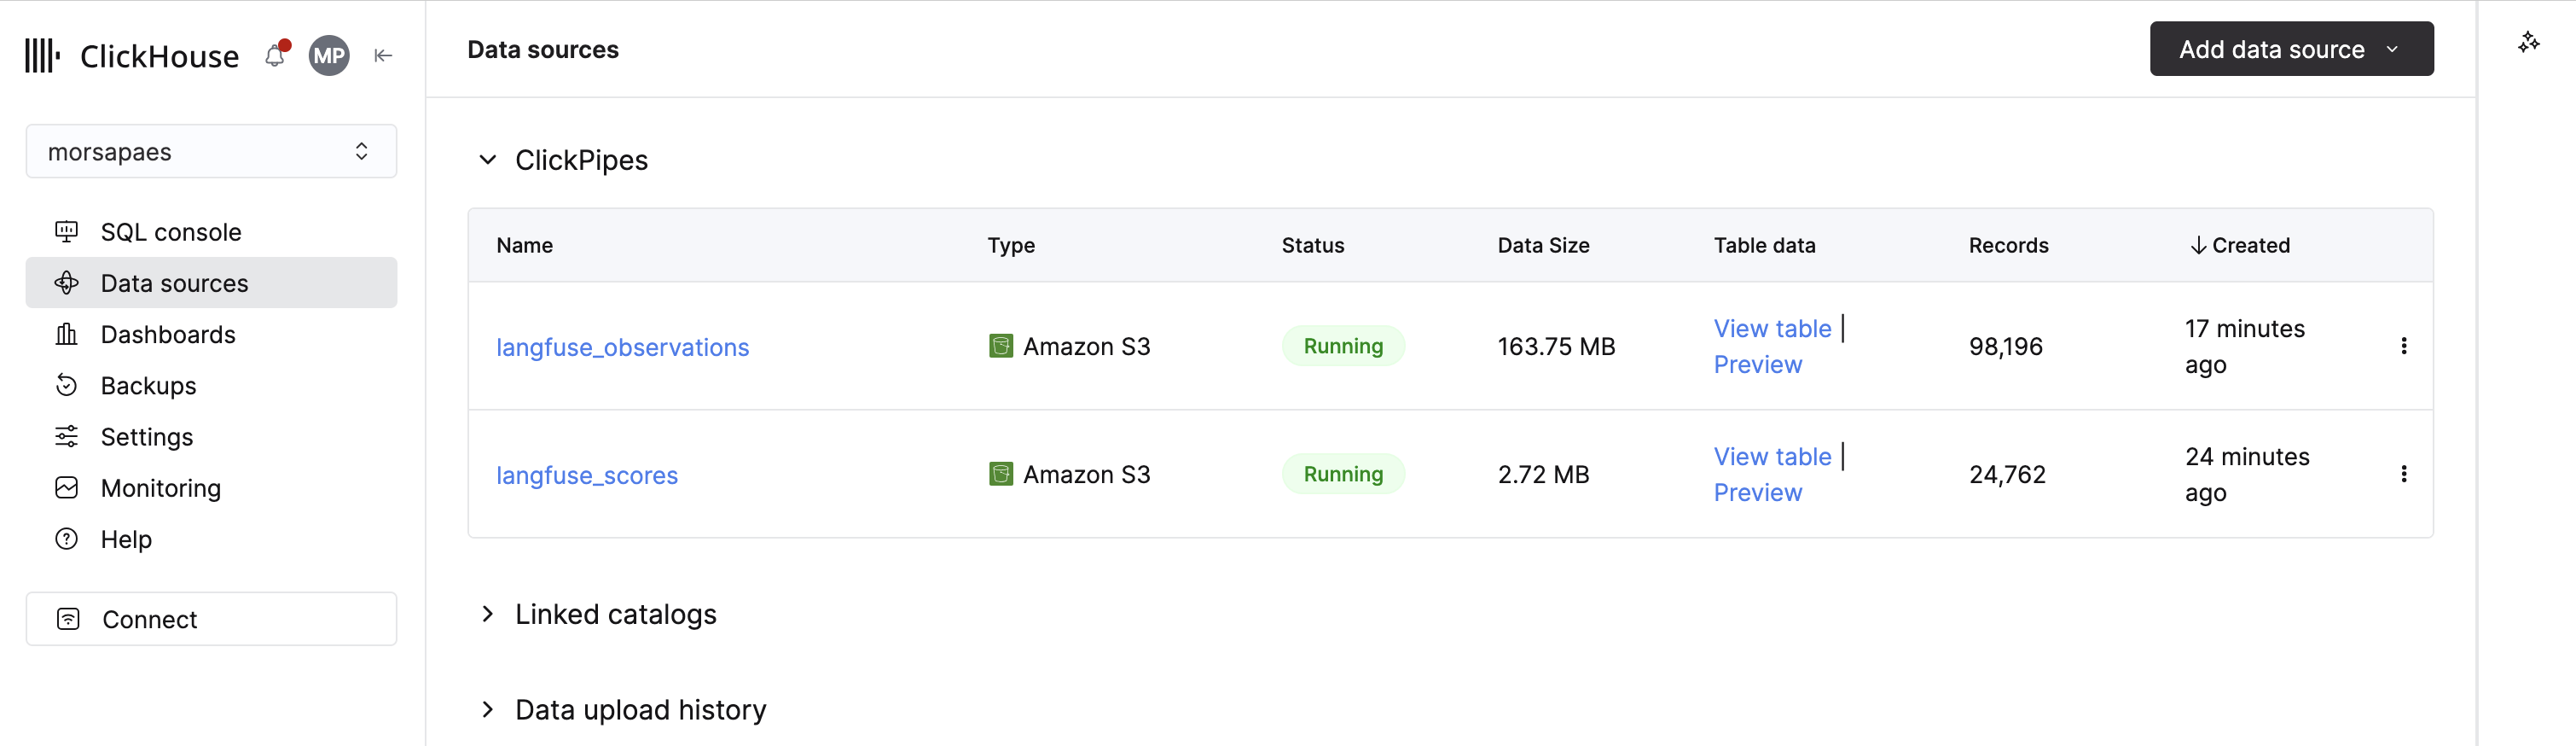
В этом примере S3 ClickPipe используется для импорта данных из S3 бакета, в который по расписанию выгружаются данные из Langfuse Cloud. Этот пример можно взять за основу и для других объектных хранилищ, в которые выполняется экспорт. Рекомендации для конкретных источников данных см. в документации ClickPipes.1
Выберите источник данных
1. В ClickHouse Cloud выберите Data sources в главном меню навигации и нажмите Create ClickPipe.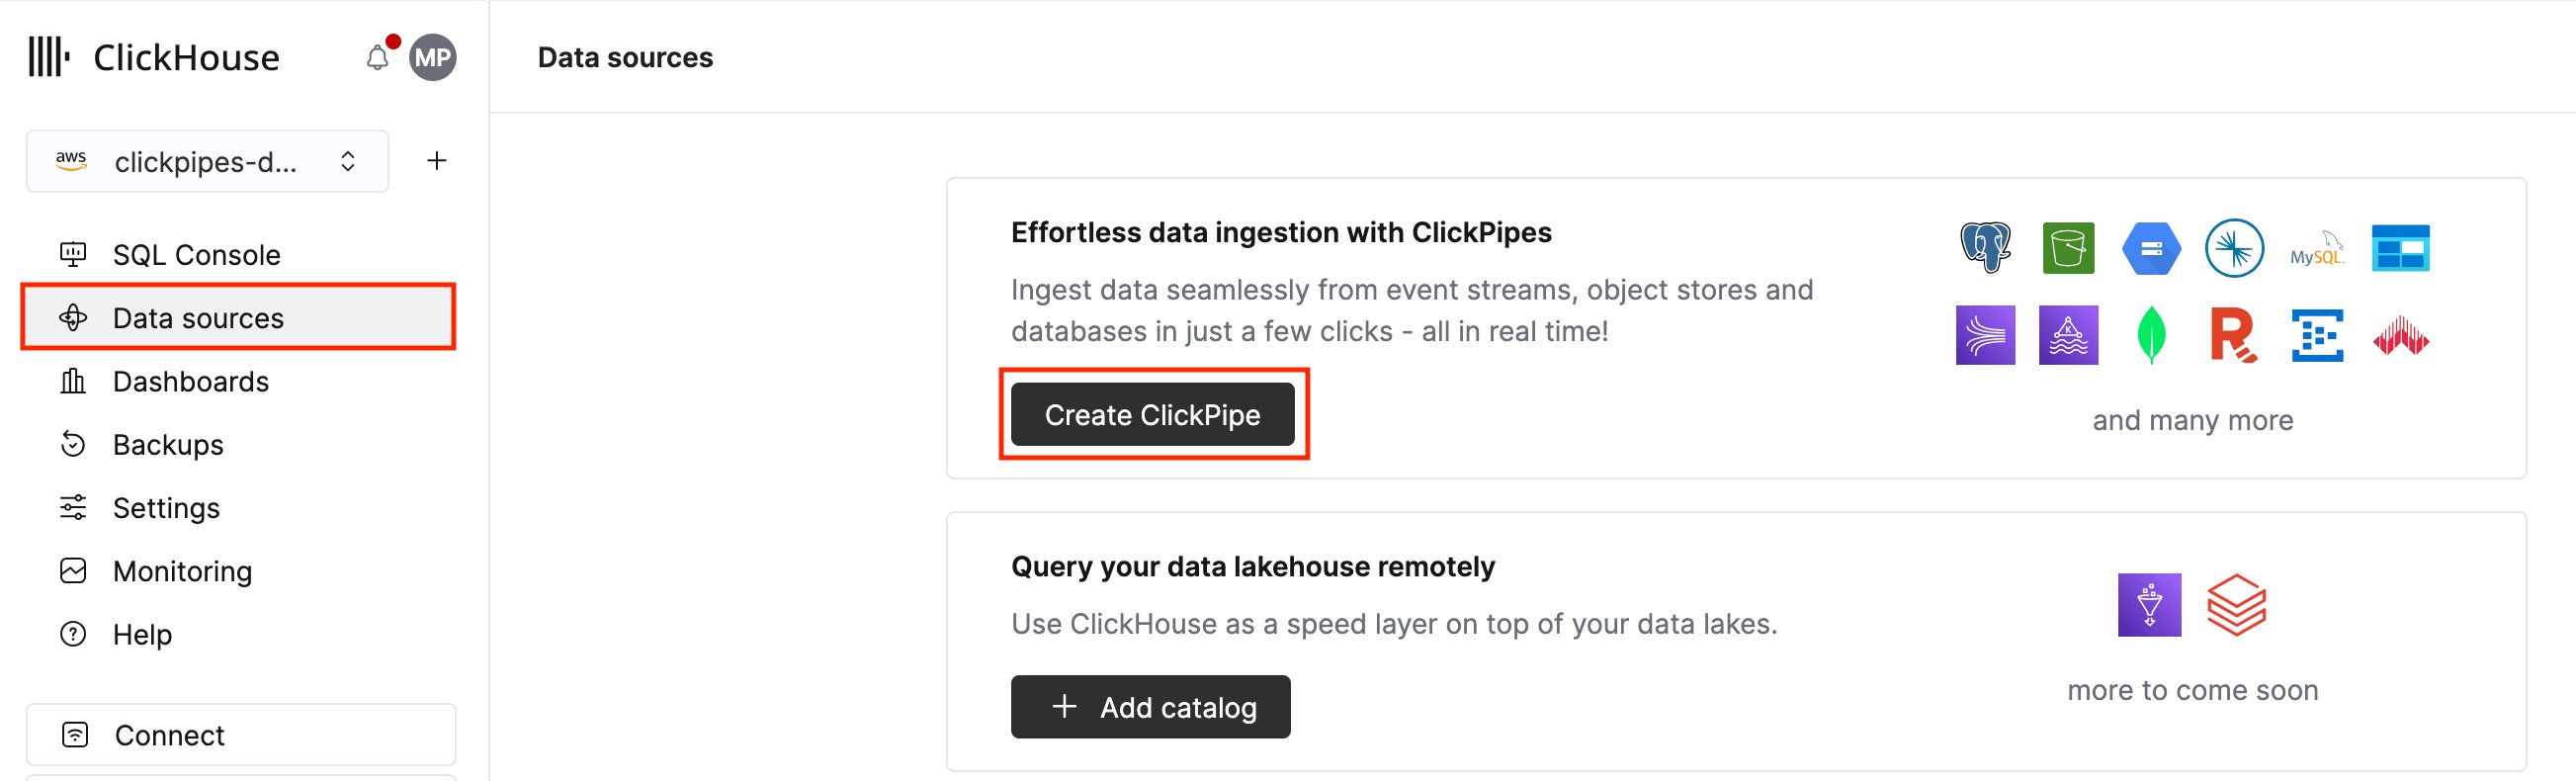
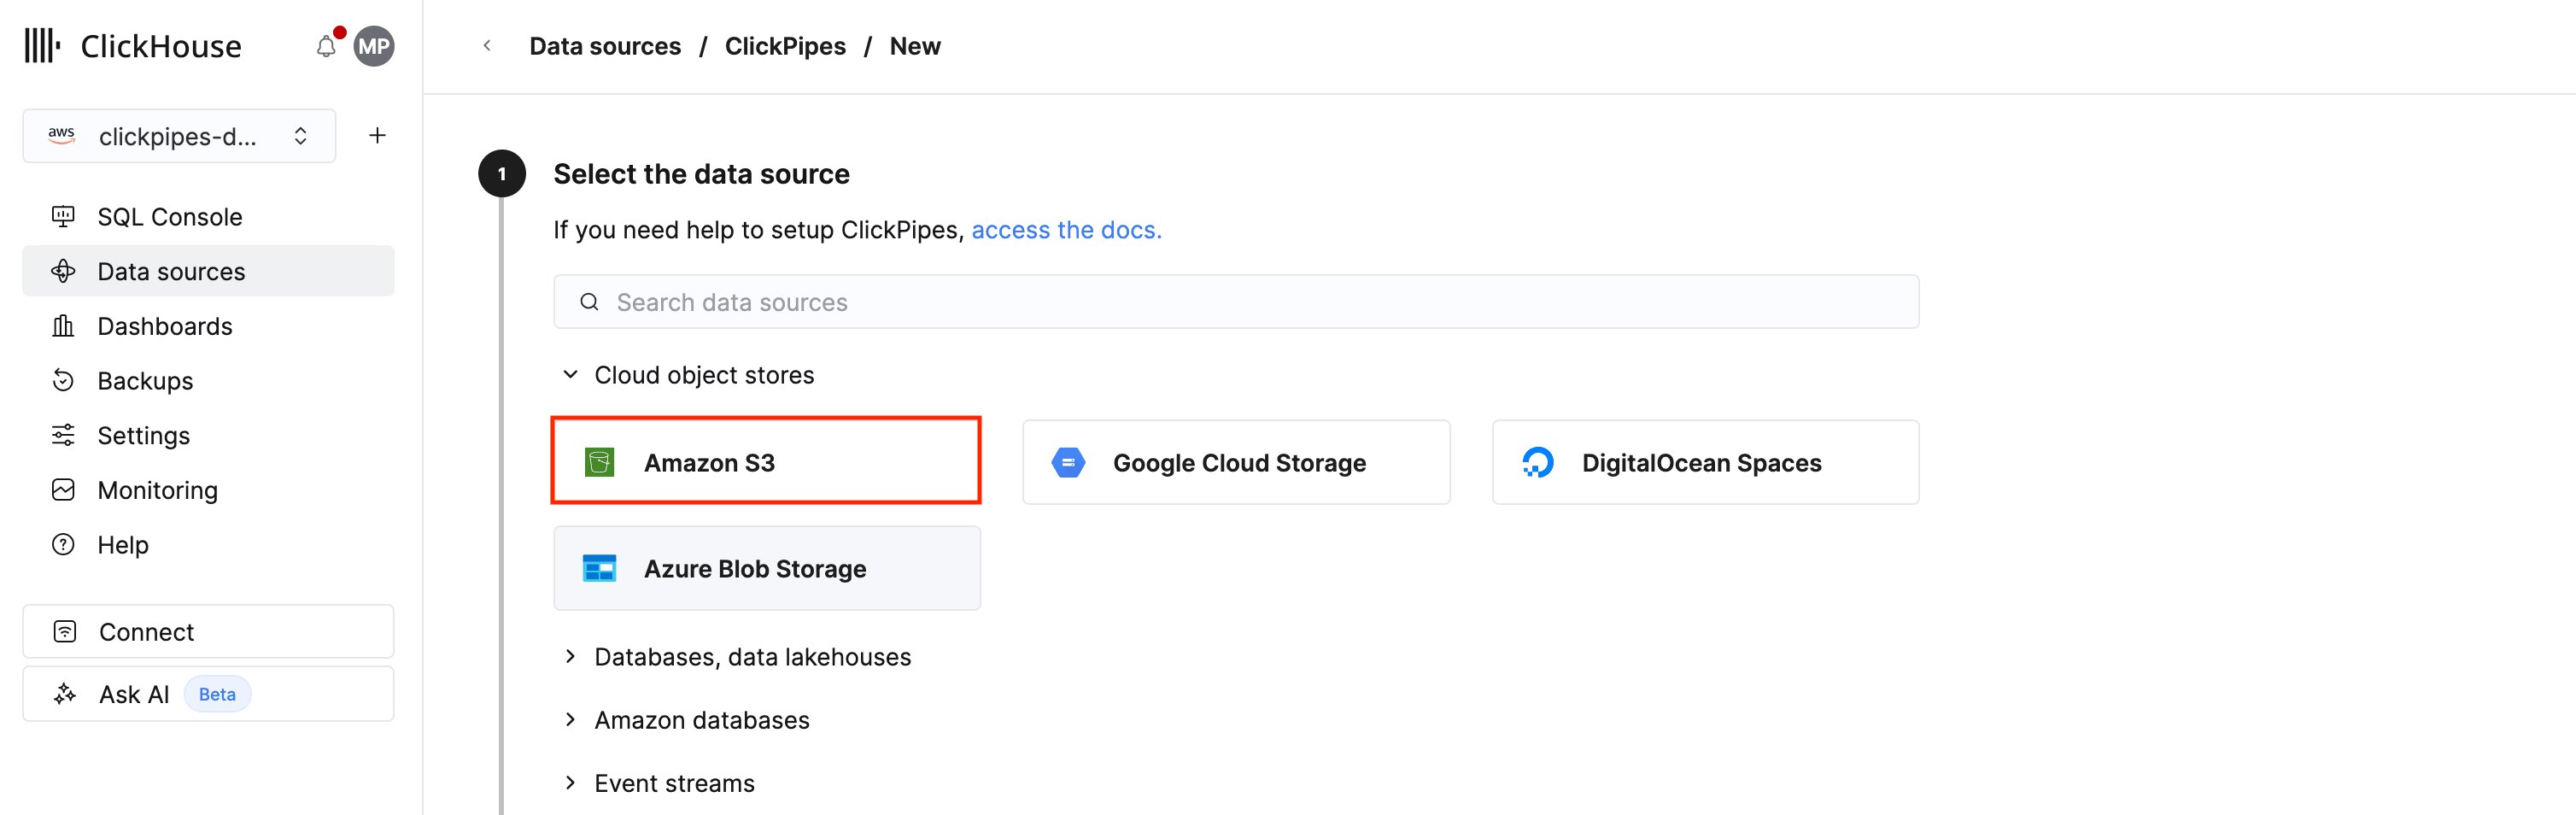
2
Настройте соединение
1. Укажите данные, которые нужны ClickPipes для подключения и аутентификации в бакете, куда экспортируются данные из Langfuse Cloud.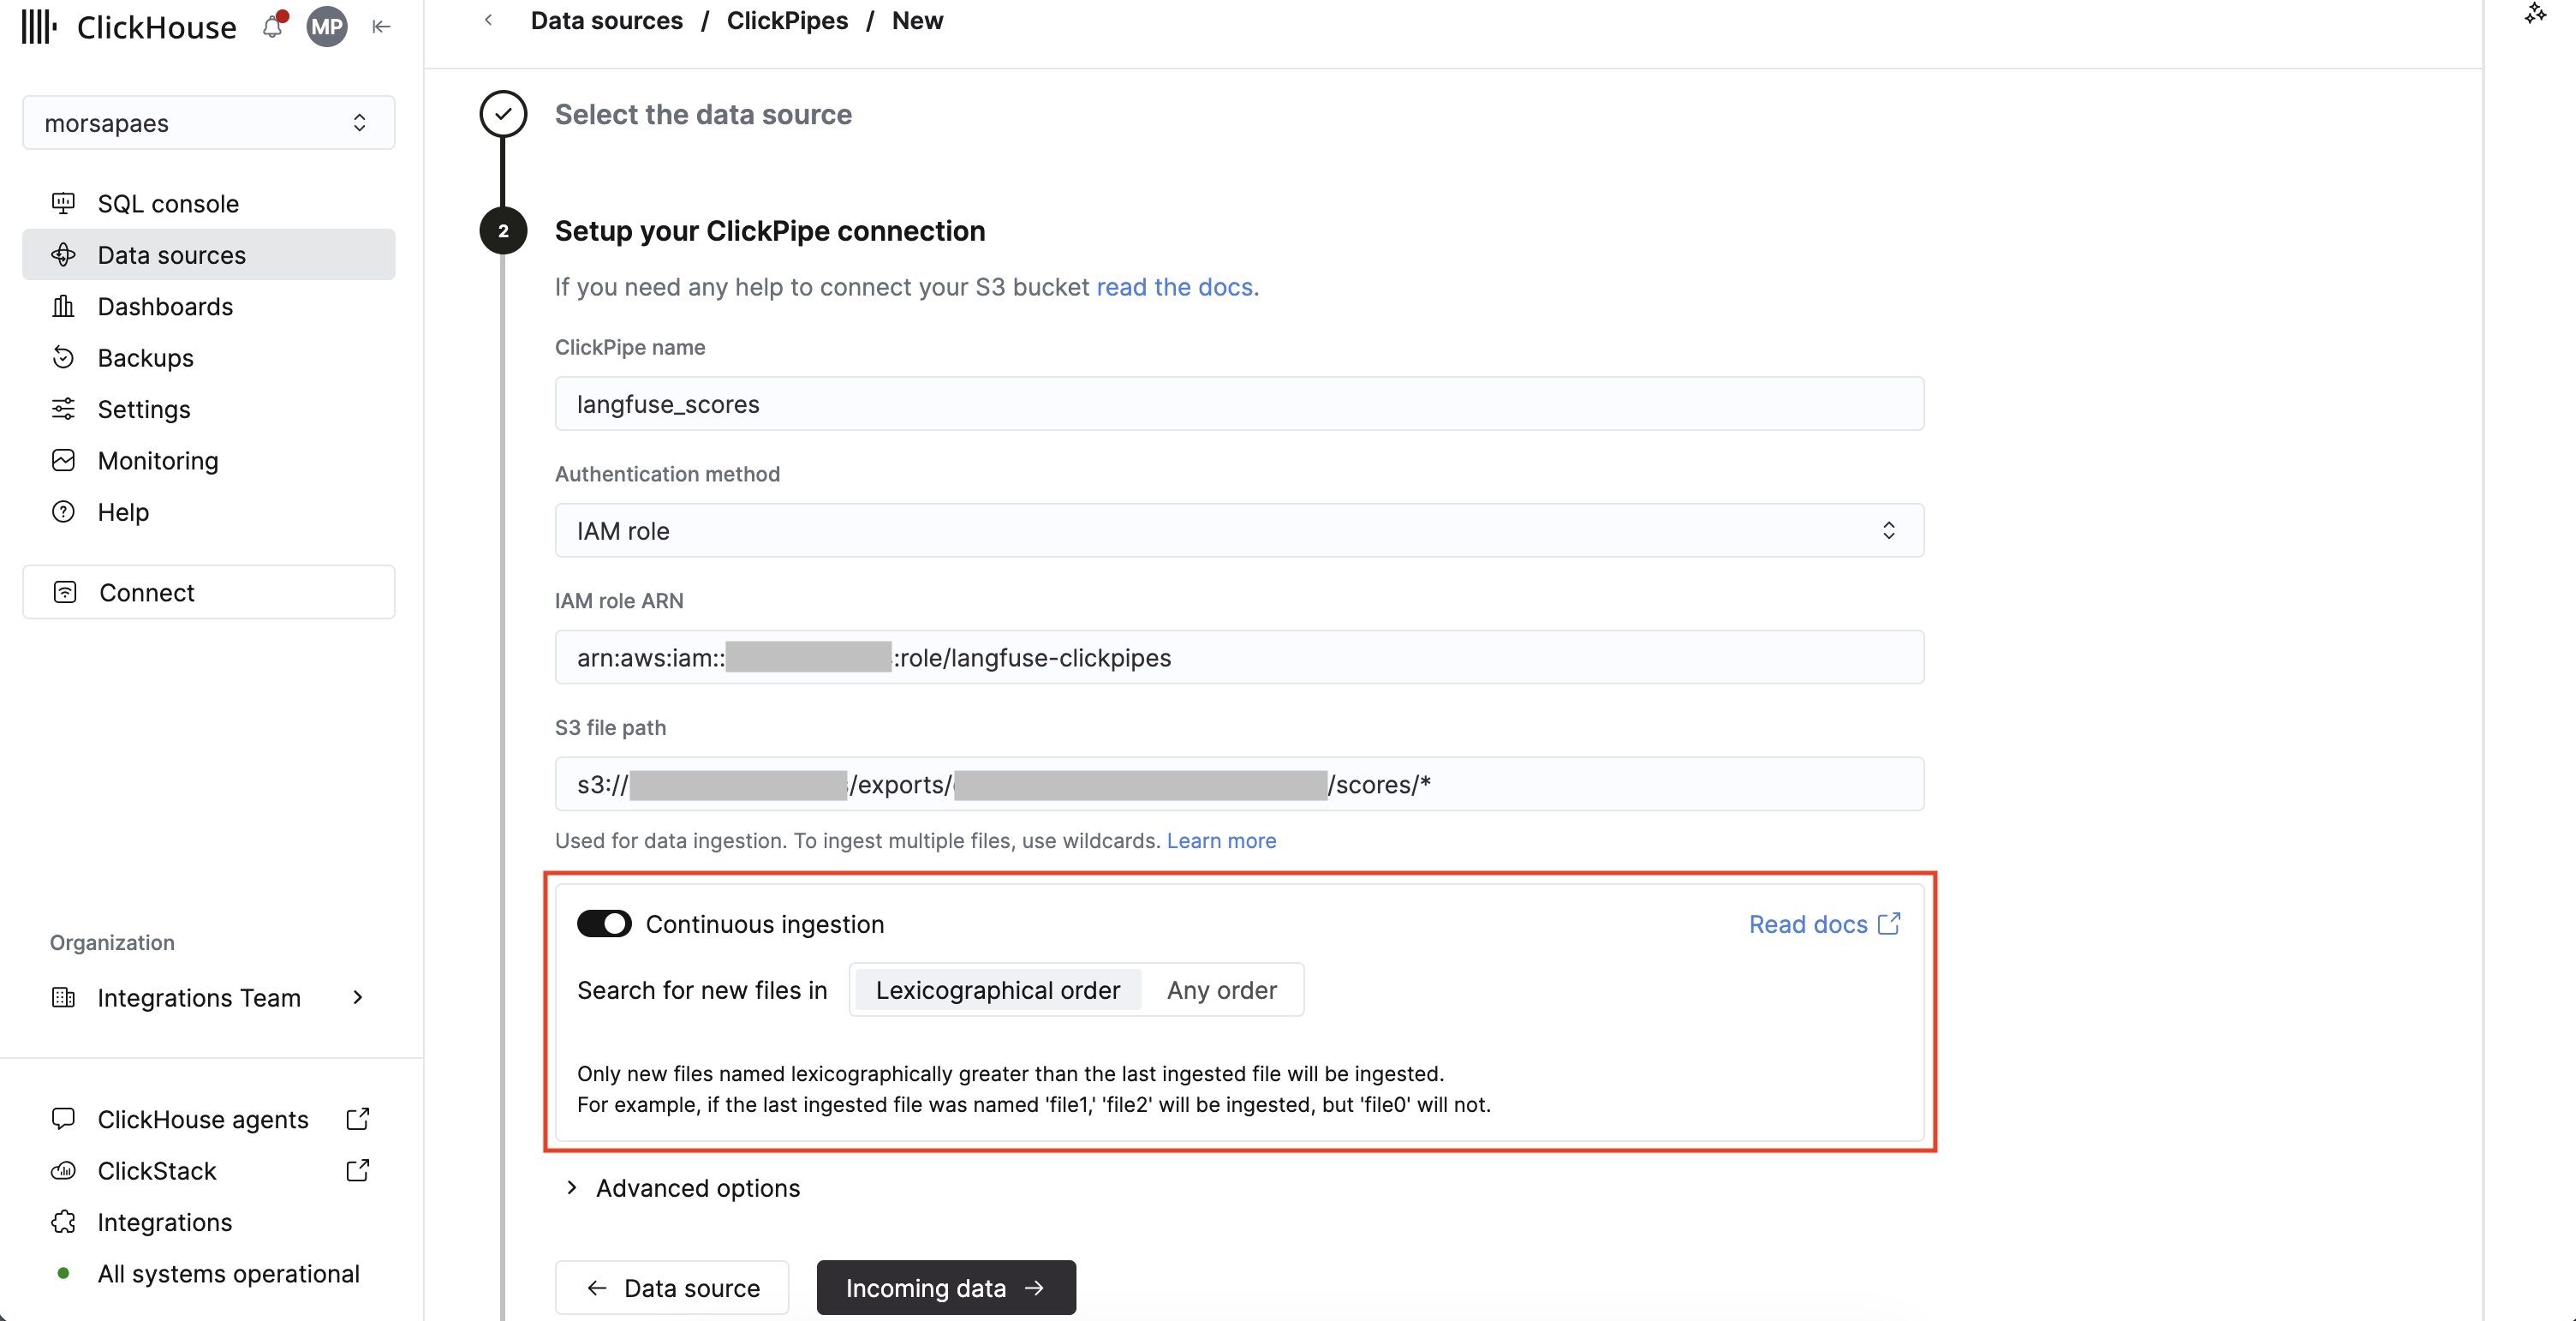
-
Authentication method: S3 ClickPipe поддерживает учётные данные IAM (
Credentials) и аутентификацию на основе роли IAM (IAM role). ClickPipes требуется только доступ к бакету на чтение. Рекомендации по аутентификации и разрешениям приведены в справочной документации. -
S3 file path: укажите для ClickPipe подкаталог и используйте подстановочный символ
*, чтобы охватить все экспортированные файлы. Для каждого подкаталога необходимо создать отдельный ClickPipe, поскольку экспортированные файлы в разных подкаталогах имеют разные схемы.Рекомендации по поддерживаемым шаблонам, в том числе по сопоставлению файлов во вложенных префиксах, приведены в справочной документации.
3
Проверьте корректность поступающих данных
1. ClickPipes подключится к вашему бакету, получит список файлов по указанному пути и автоматически определит их формат. В этом примере используется формат экспорта Langfuse Cloud по умолчанию (Parquet).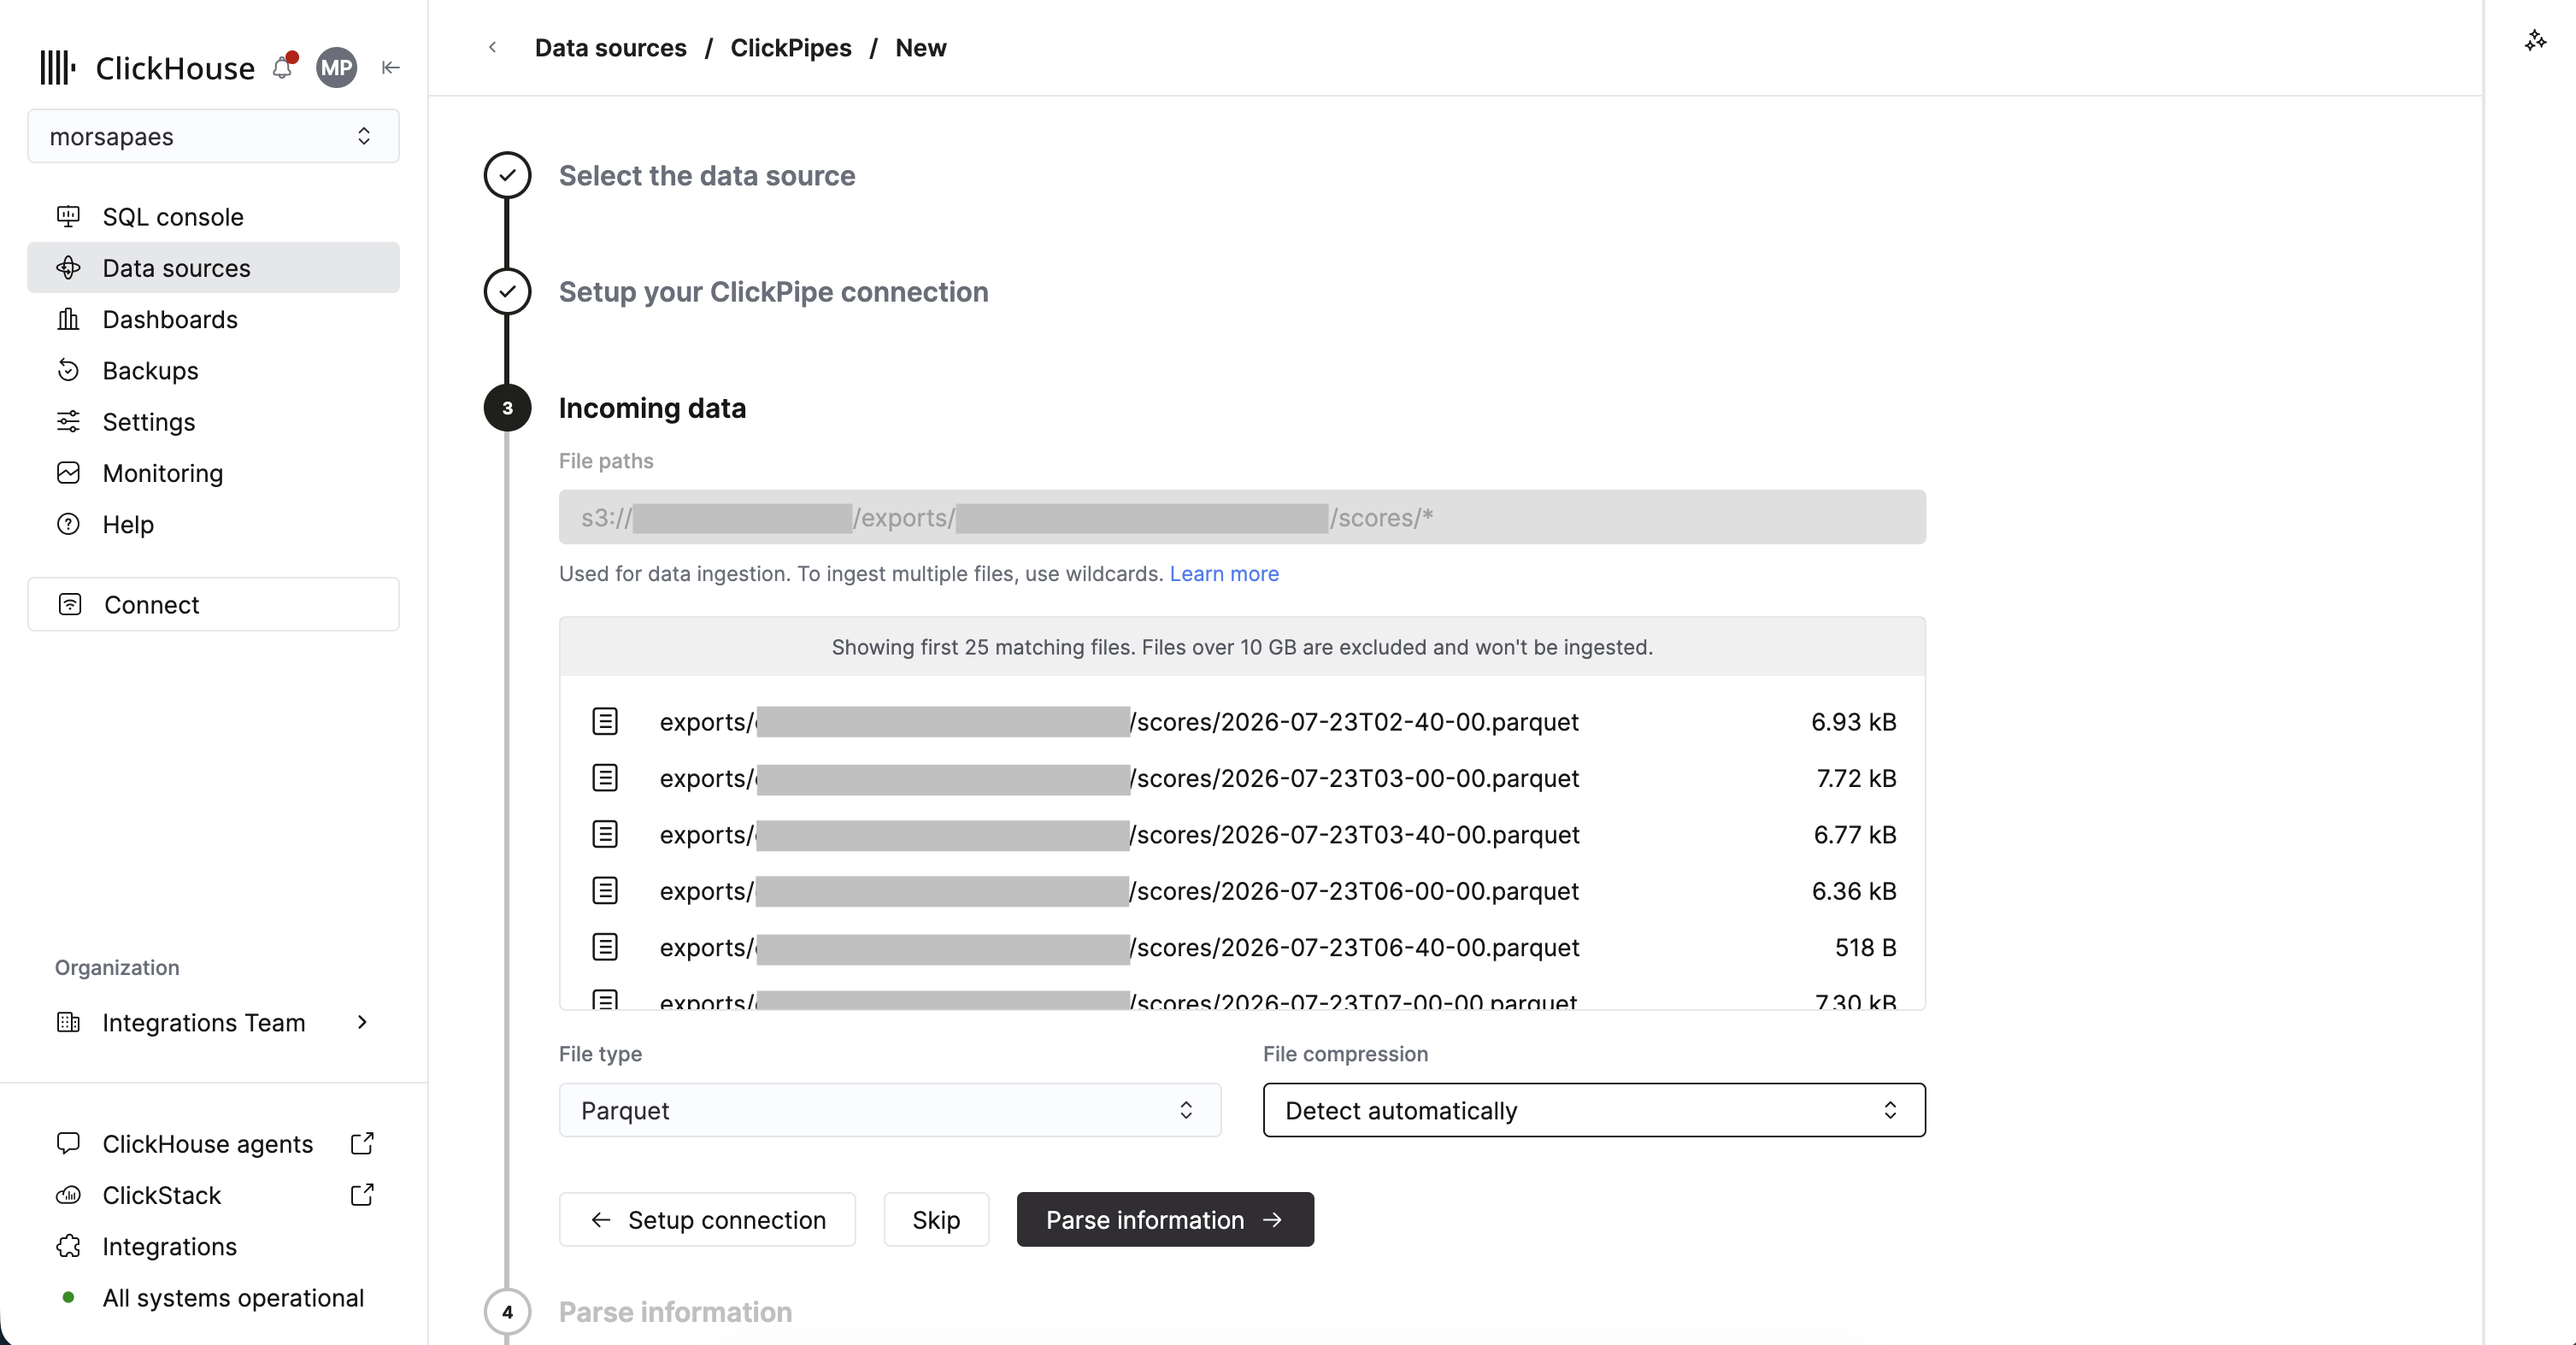
4
Настройте целевую систему
1. На этом шаге можно просмотреть автоматически определённую схему и настроить параметры целевой таблицы: скорректировать сопоставление типов данных, задать ключ сортировки и выбрать движок таблицы.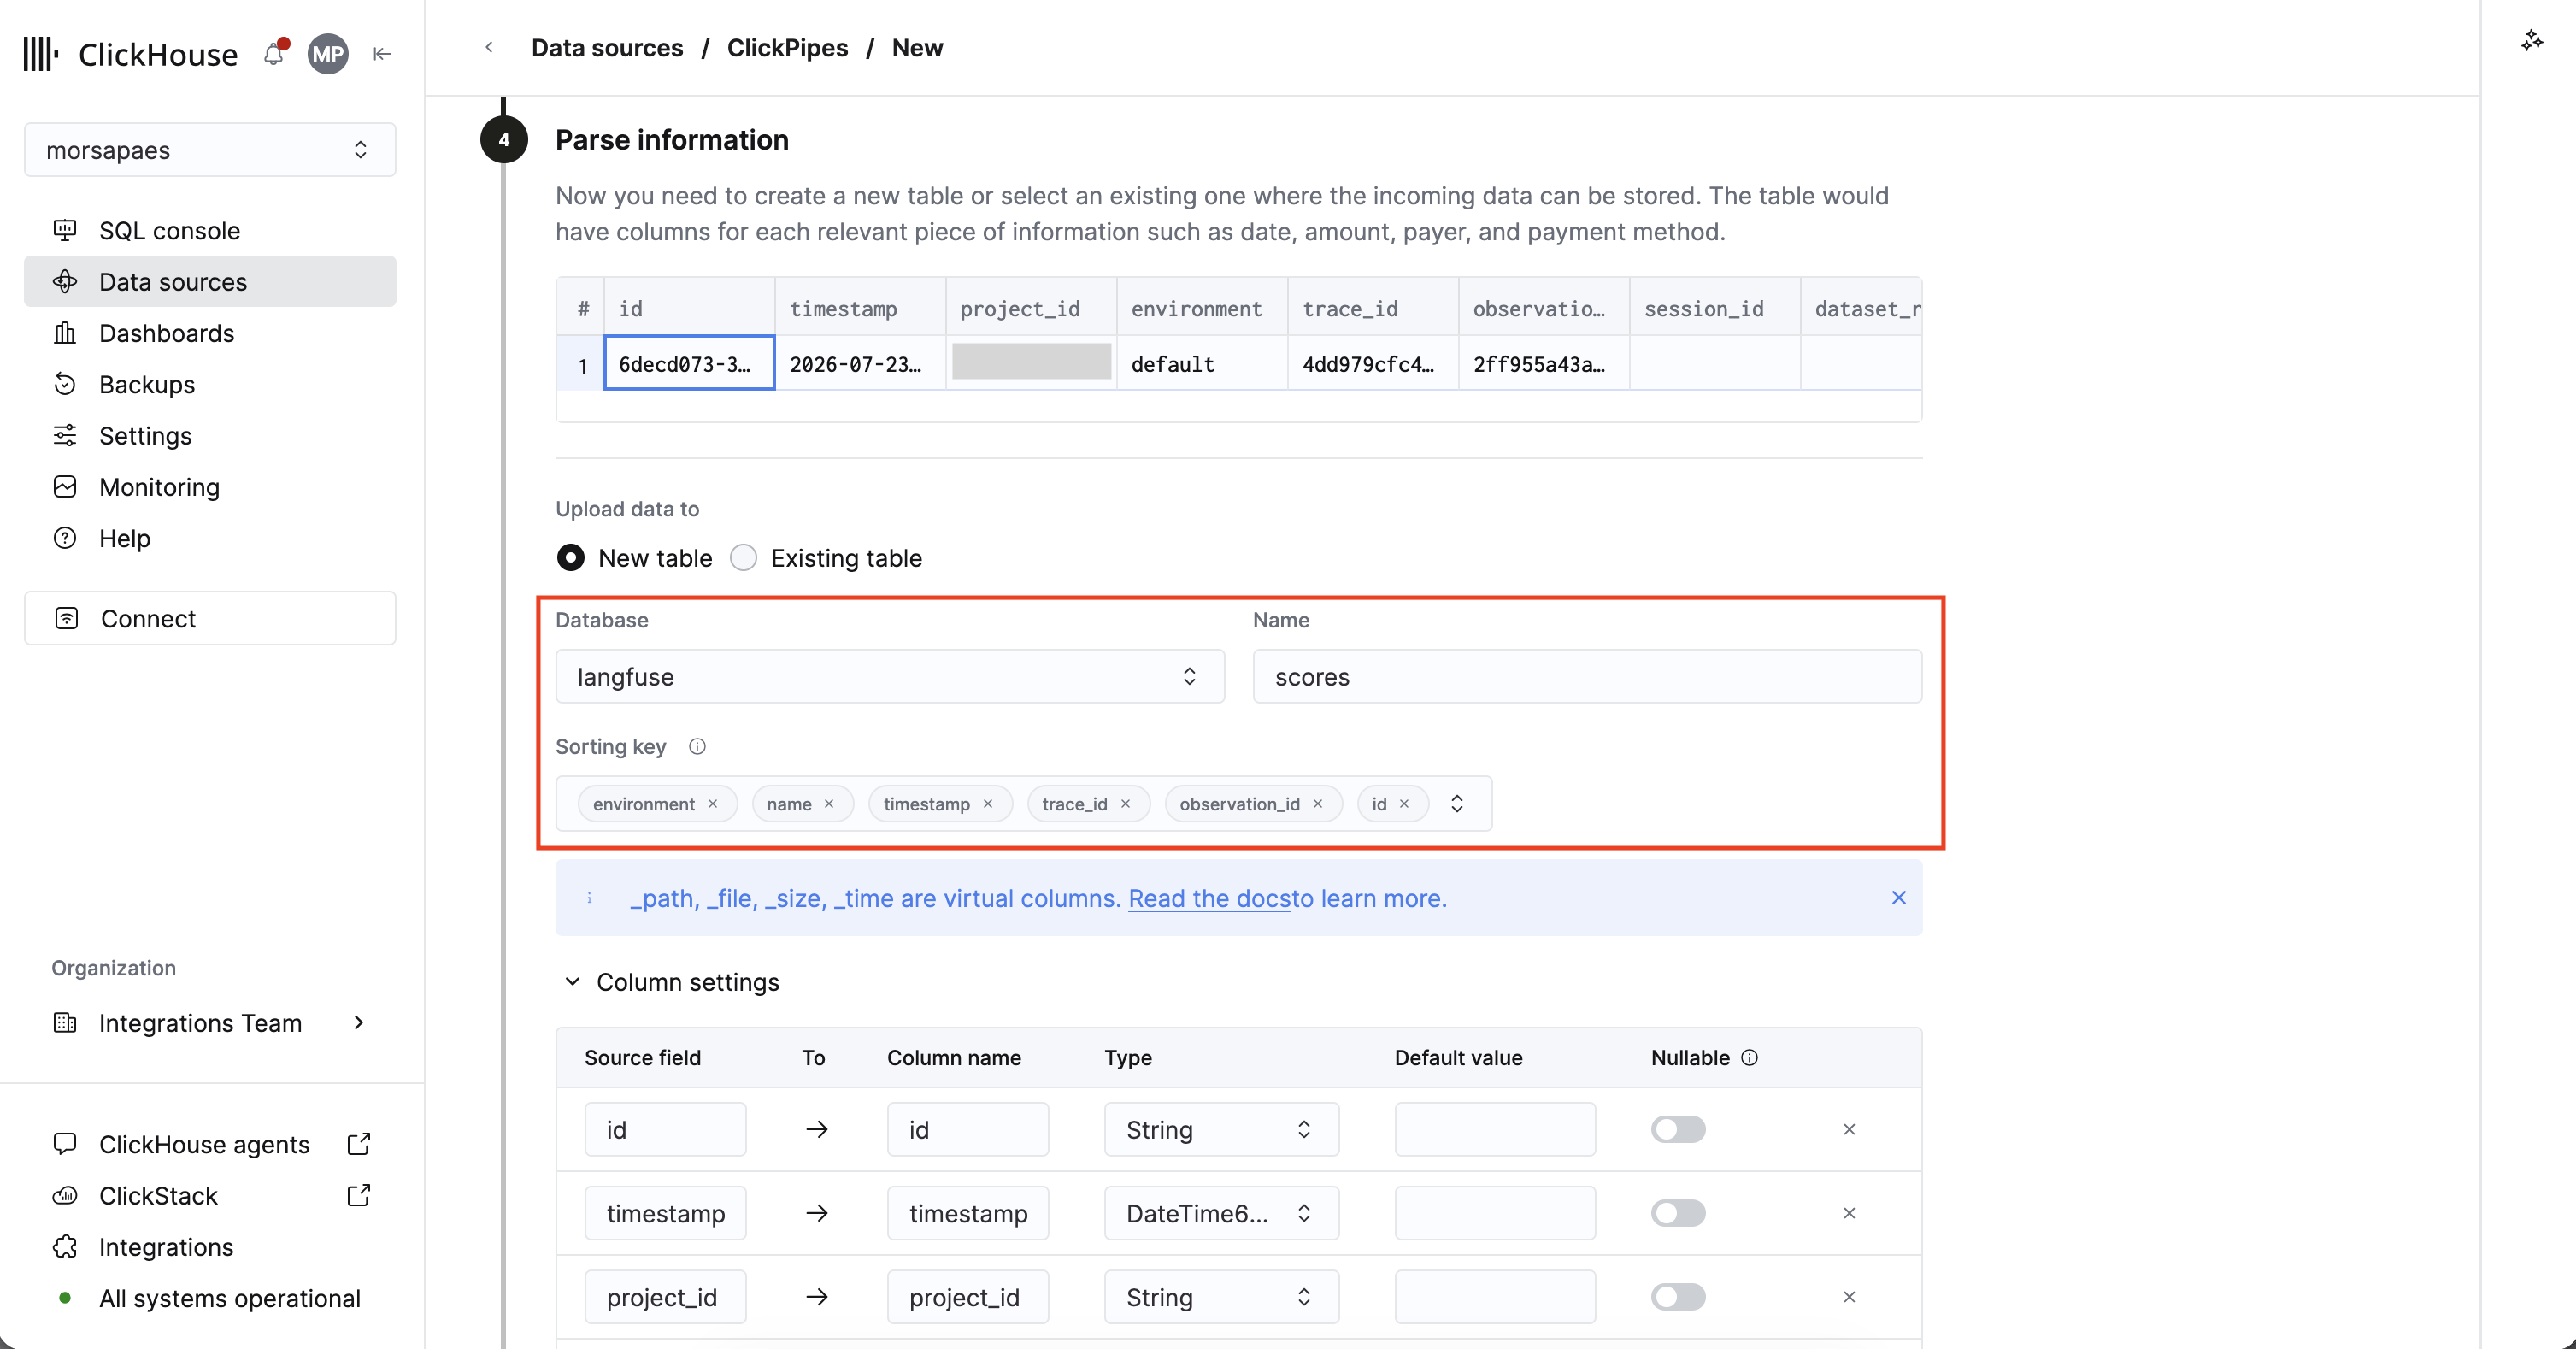
-
Database и Name: отдельную базу данных для данных Langfuse (например,
langfuse) и понятное имя целевой таблицы (например,scores). По умолчанию ClickPipes используетdefault.s3-<uuid>, чтобы избежать конфликтов имён. -
Sorting key: ключ упорядочивания целевой таблицы, который определяет, как ClickHouse хранит данные на диске. Для оптимальной производительности ключ сортировки должен соответствовать тому, как ваши запросы обращаются к данным, — тогда они смогут пропускать чтение как можно большего объёма данных.
Этот ключ также используется для дедупликации в таблицах
ReplacingMergeTree, поэтому набор столбцов должен однозначно идентифицировать запись. Если вы загружаете несколько проектов Langfuse в одну таблицу, добавьтеproject_idв начало ключа сортировки. Рекомендации по выбору ключа сортировки см. в справочной документации. -
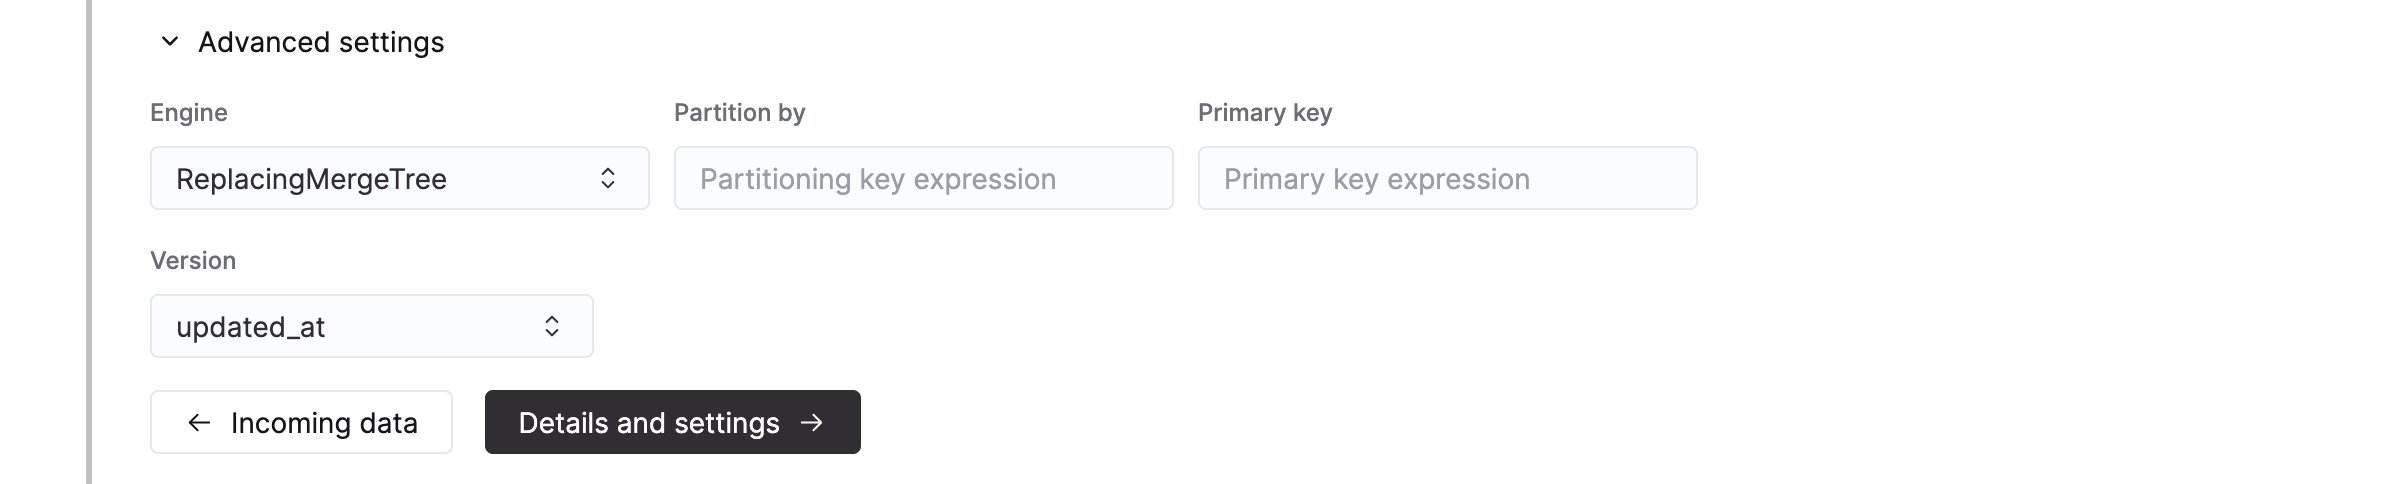
Partition by: оставьте поле пустым, если не планируете удалять устаревшие трассировки. Партиционирование в ClickHouse предназначено для управления данными, а не для оптимизации запросов; рекомендуемый ключ сортировки и так отсекает лишние данные в запросах по временному диапазону. Если же нужно ограничить срок хранения, партиционируйте таблицу по столбцу времени (
toYYYYMM(start_time)илиtoYYYYMM(timestamp)дляscores) — тогда удаление трассировок за месяц сведётся к одной операцииDROP PARTITION.
ReplacingMergeTree, чтобы обеспечить дедупликацию, и укажите updated_at в качестве столбца Version.uniq(), max(), min()), вы обязаны обрабатывать дедупликацию на уровне последующей модели данных, используя ReplacingMergeTree в качестве целевого движка.Дедупликация с помощью ReplacingMergeTreeЭтот движок таблицы схлопывает дубликаты во время фоновых слияний. Для полной дедупликации при чтении (т. е. семантики merge-on-read) необходимо использовать в запросах модификатор
FINAL (или агрегации в стиле argMax()).5
Настройте разрешения
ClickPipes создаёт отдельного пользователя для записи данных в целевую таблицу. Выберите для этого внутреннего пользователя пользовательскую роль или одну из предопределённых ролей: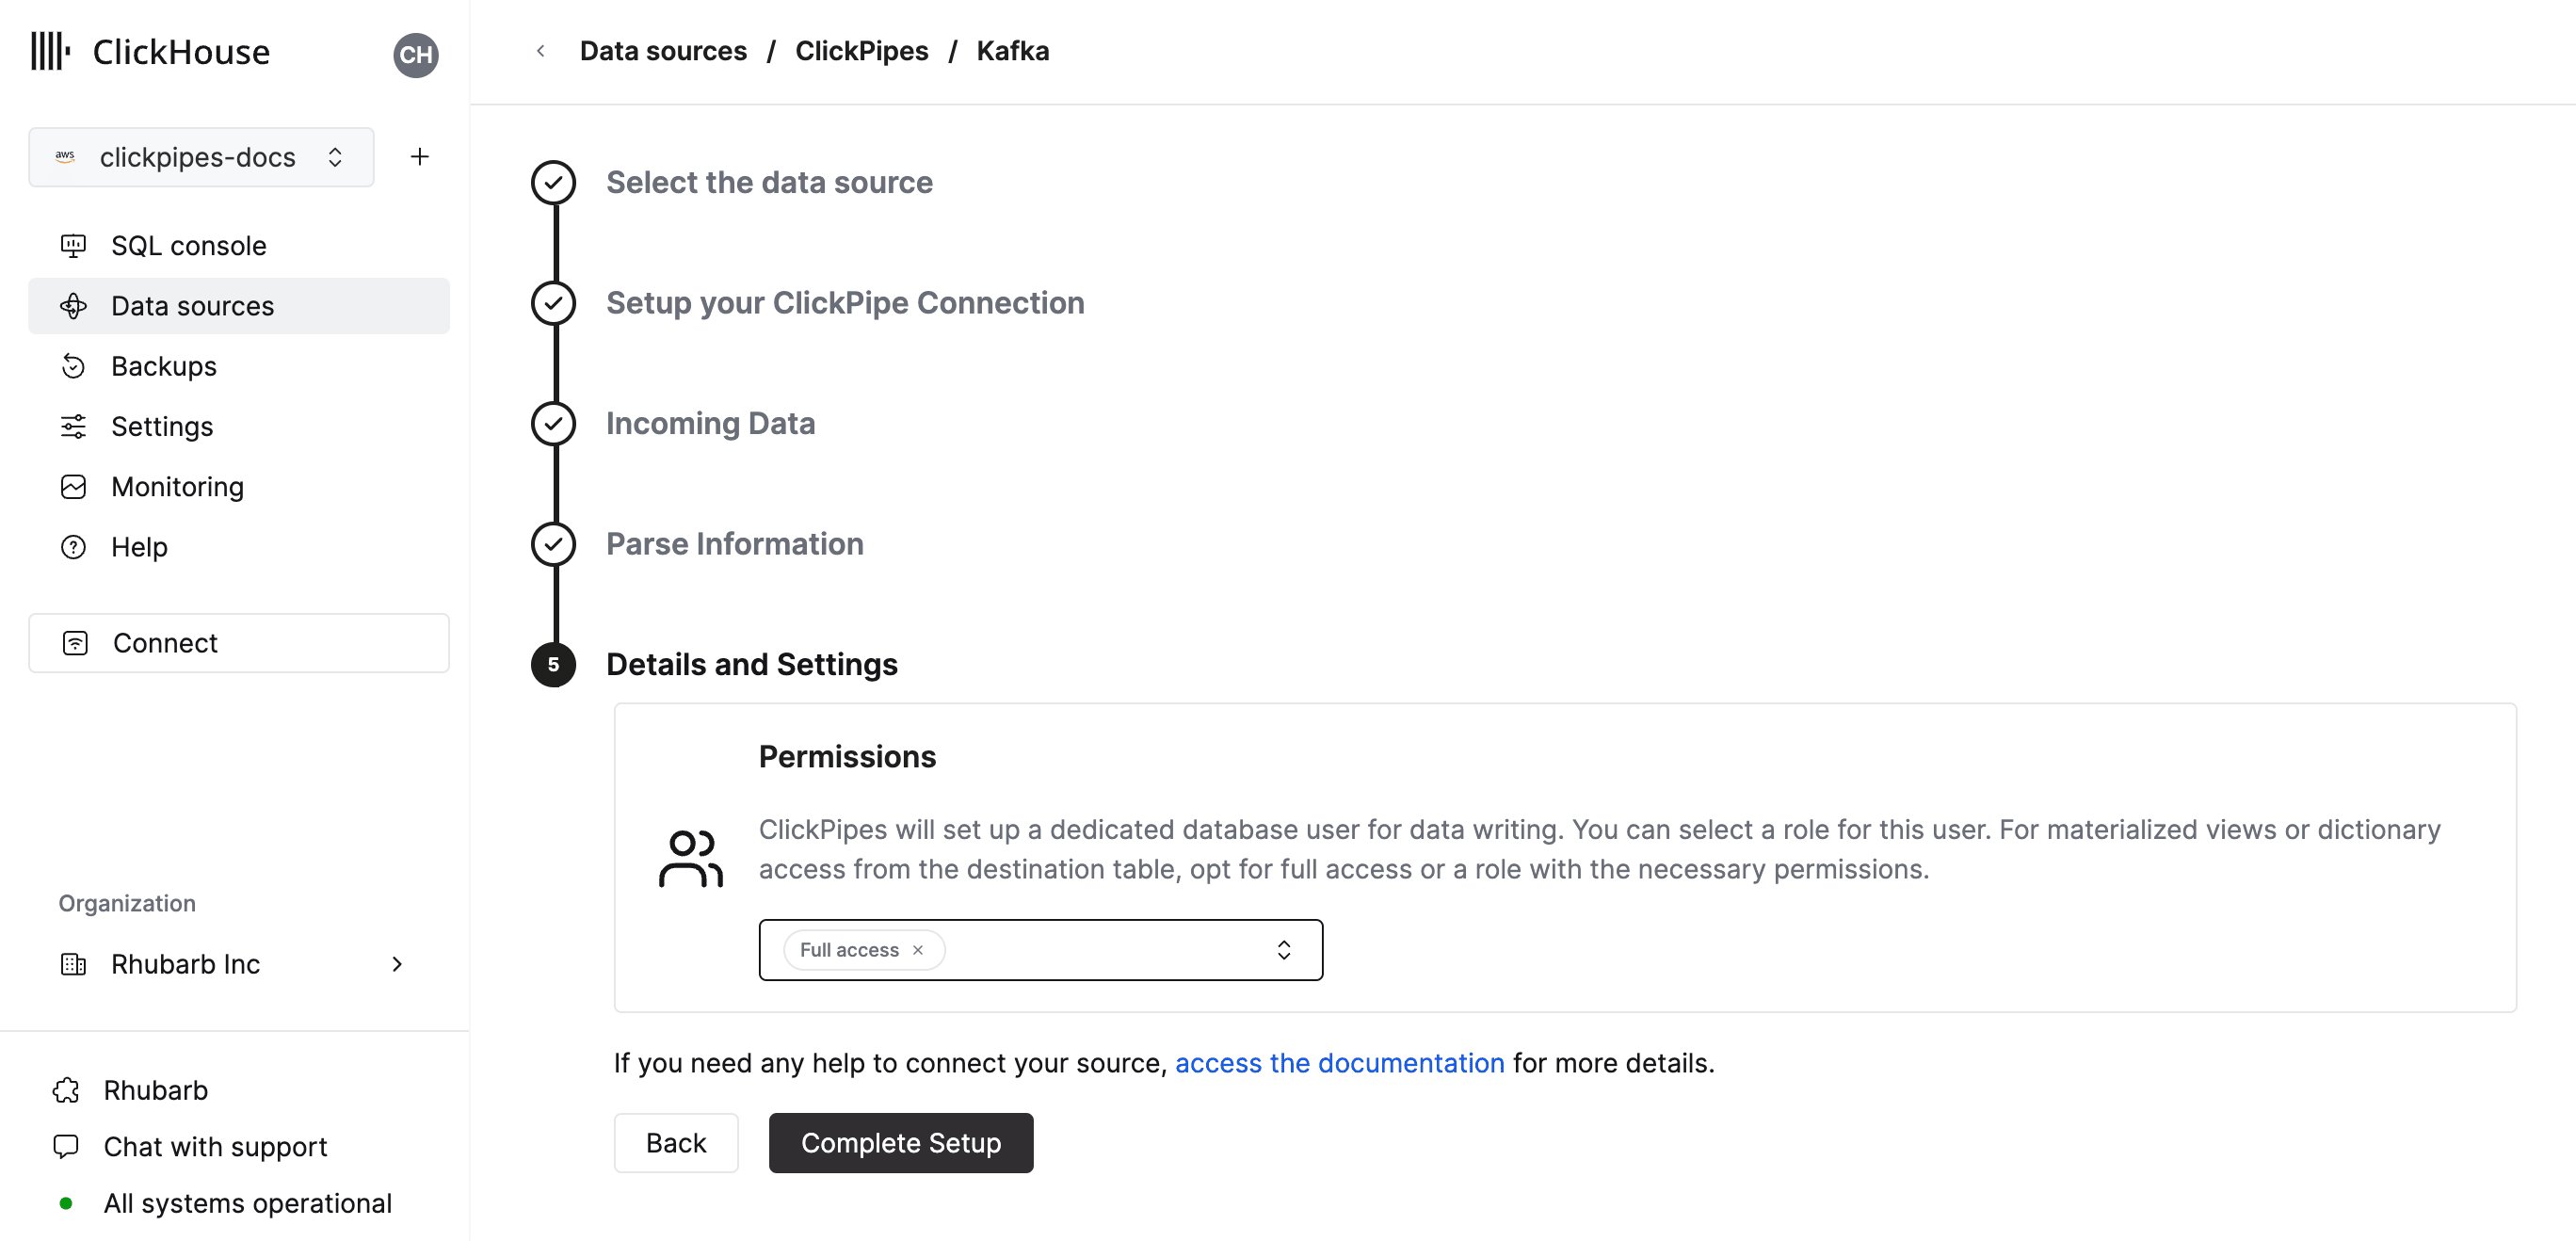
Full access: полный доступ к кластеру. Требуется, если с целевой таблицей используется materialized view или словарь.Only destination table: разрешенияINSERTтолько на целевую таблицу.
6
Завершите настройку
Готово! Сначала ClickPipes выполнит дозагрузку исторических данных из всех файлов по указанному пути, а затем начнёт принимать новые файлы по мере их поступления в бакет.